训练与测试流程
整体思路:训练 = "上学",给机器人看大量示范视频(样本),让它反复练习、批改、订正;测试 = "考试",机器人不能再偷看答案,凭学到的本事独立完成任务。整个流程分三步走。
训练 Step 1 & 2:拿出一份样本,猜猜它的"风格"
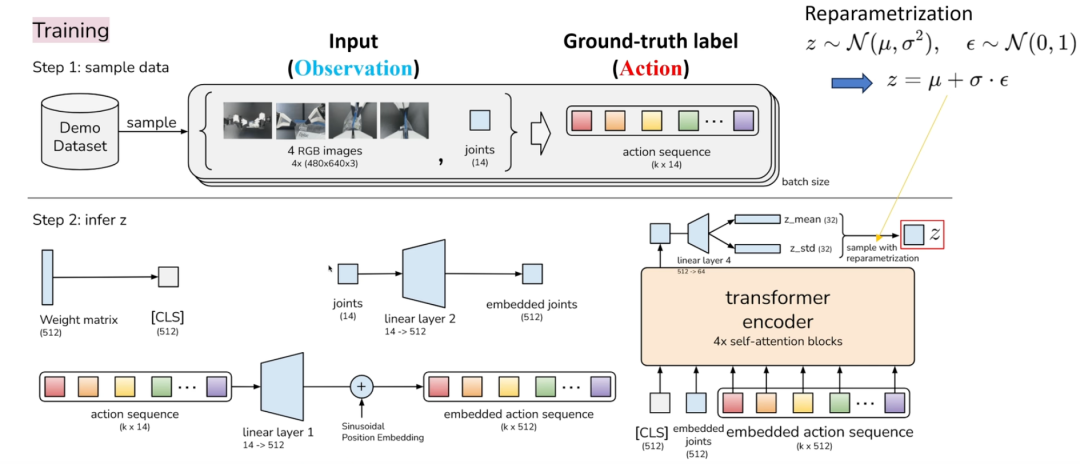
Step 1 · 从"录像带库"里抽一份样本
人类示范的所有录像被存放在一个数据库里,叫 Demo Dataset(示范数据集)。你可以把它想象成一个装满教学录像带的仓库。每次训练,模型从中随机抽出一份"教学片段",这份片段包含三样东西:
| 数据 | 内容 | 类比 |
|---|---|---|
| 📷 4 张彩色照片 | 机器人"看到"的画面 | 你的眼睛看到的 |
| 🦾 14 个数字:当前姿势 | 7 个关节 × 每个关节 2 个数字(角度、速度) | 你此刻手脚的位置 |
| ✅ k×14 个数字:标准答案 | 接下来 k 个时刻、每个时刻 14 个数字的真实动作 | "师傅接下来会怎么做" |
大白话:就像老师随机抽出一段教学录像,画面、学生当时的姿势、以及老师接下来的标准动作,三者一起交给学生。
Step 2 · 推断"风格" z
拿到标准答案后,模型要猜一个东西:这段示范的"风格" z 是什么?
为什么要猜风格? 因为同样一个任务,不同人做起来细节不一样:有人倒油快、有人慢,有人把盘子放得靠左、有人靠右。如果模型每次只能输出唯一的一种动作,遇到"多种可能都正确"的示范时就会左右为难、学不好。z 就是一个"随机风格开关",让模型明白:同一画面可以有不同的合理动作。
具体过程分四小步:
- 线性层投影到 512 维:把"当前姿势"和"标准动作"这些数字,统一转换成模型规定的标准尺寸(512 个数字)。就像所有文件都转换成统一的 PDF 格式,方便处理。
- 加上正弦位置编码:给序列里每个位置打上"我是第几位"的序号标签,模型才能分清先后顺序。
- 送入 Transformer Encoder:一个擅长处理"序列信息"的神经网络,把整段动作序列读完,提炼出"这段动作的特点"。
- 输出 μ、σ,再重参数化采样:模型不直接给出唯一的 z,而是给出 z 的"中心位置 μ"和"波动范围 σ"。然后做一次随机抽取:
z = μ + σ × ε,其中 ε 是从标准正态分布N(0, 1)里随机抽的小数。
为什么要这么绕(重参数化技巧)? 因为"随机"本身没法被神经网络训练(没法求导),而"μ 和 σ"可以。重参数化技巧相当于把随机性从模型内部"抽出来",变成在外部加一个随机数——这样模型照样能被训练,同时动作又保留了多样性。打个比方:不是让厨师随机发挥,而是给厨师一个"随机口味的盐勺",口味多变但手法可控。
训练 Step 3:只看"条件",预测未来动作
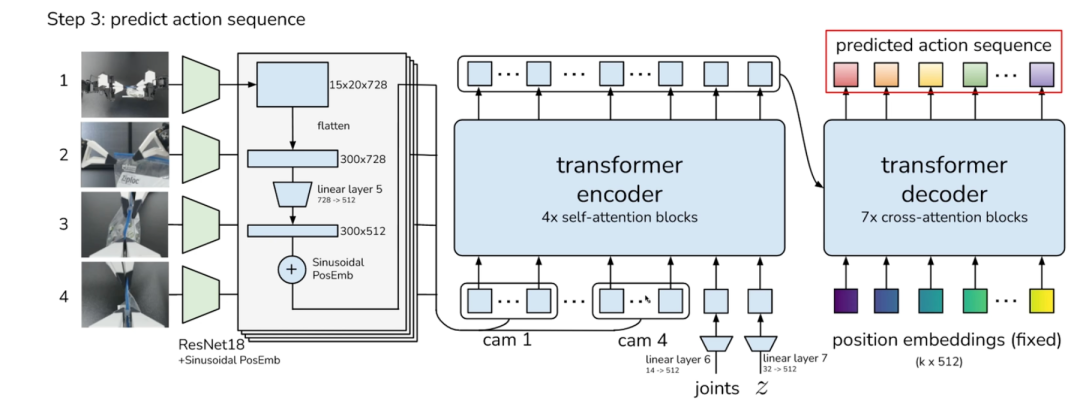
这一步才是真正的"答题"。模型不看标准答案,只凭"看到的画面 + 当前姿势 + 风格 z"来预测未来动作,然后跟标准答案对比、接受批评。
- A · 4 张照片交给"看图专家" ResNet18:18 层神经网络把每张照片压缩成一组有意义的数字(特征),再打上位置标签。看图专家把"锅里冒烟、菜叶发黄"这类信息提取出来,并标注是第几张照片。
- B · 当前姿势 + 风格 z 也转换成标准尺寸:14 个姿势数字和风格 z 分别经过线性层,都变成 512 维的"统一格式",方便和图片信息一起送入大脑。
- C · 编码器整理"情况简报":把"看到的画面、身体姿势、动作风格"全部汇集起来,整理成一份"当前情况简报",供解码器随时查阅。
- D · 解码器反复"查资料",一次想好 k 步:解码器里有 7 个 cross-attention(交叉注意力)模块,每次"想动作"时都回头反复查看简报,判断哪条信息最重要(比如:现在该看锅里的菜,还是该看手的位置),7 层相当于反复推敲 7 次。解码器开头放好了固定的位置编码(1 号位、2 号位……k 号位),所以它能一次性把未来 k 步动作全部想好,而不是想一步、做一步、再想一步。
怎么算"学得好不好"?—— 两个"老师"打分
| 老师 | 损失 | 作用 |
|---|---|---|
| 老师一 | MSE 损失(预测准不准) | 把模型预测的 k 步动作,和录像里真实的标准动作逐位相减、求平均差距。答案写得和标准答案越接近,得分越高 |
| 老师二 | KL 散度(风格别太离谱) | 强制风格 z 的分布保持在"标准随机"附近,防止风格编码器"作弊"——比如把整个标准答案原封不动塞进 z 里。如果 z 里藏了答案,那考试时 z 一旦置零,模型就啥都不会了 |
大白话总结训练:两个老师一起打分——一个看"预测得准不准",一个看"有没有偷偷依赖随机数"。模型顺着这两个分数反复修改自己的参数(梯度下降),训练几万次之后,就真正学会了"看到什么画面 → 做出什么动作"的规律。
测试阶段:考试开始了,机器人独立上岗
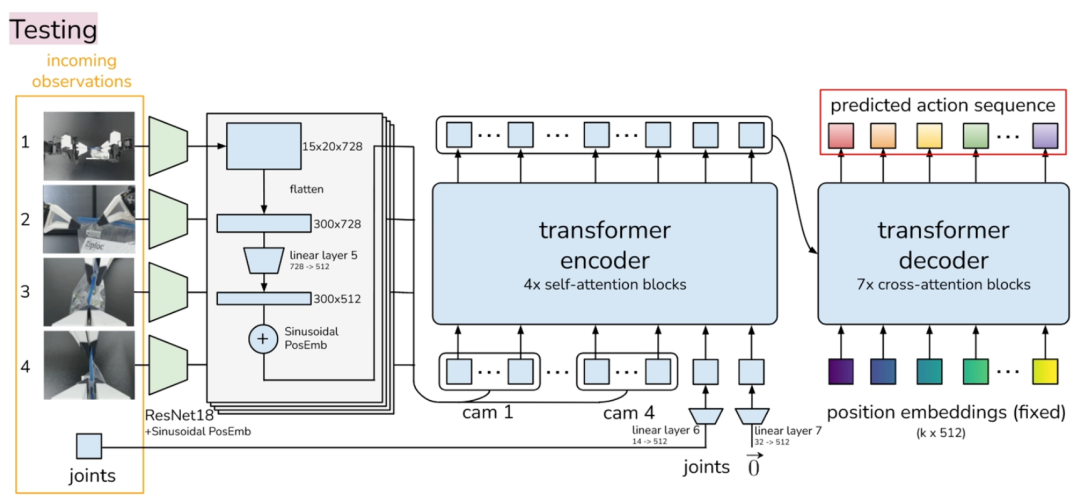
- 没有标准答案了,z 直接置零:测试时机器人看不到任何标准动作(本来就没有录像),所以风格编码器被关掉,
z = 0。考试时答案被收走,只能凭本事做题。 - 输入只有"现场观测":模型只接收现场观测(incoming observations):4 张摄像头实时画面 + 14 个当前关节数字。这就是测试时唯一能用的信息。
- 一次输出未来 k 步动作,Follower 照做:主 Transformer 根据现场观测,一口气输出未来 k 步动作。Follower Arm(执行臂)按顺序依次执行。
- 配合 Temporal Ensemble,动作丝滑不抖动:相邻两次预测的动作块会有重叠,系统把重叠部分按加权平均融合,保证机器人的动作连续、平滑、不抽搐。
为什么它真的会做?
因为在训练时,它已经看过成千上万份"画面 + 对应动作"的示范,学会了规律:"看到锅冒烟 → 该翻菜了""看到手接近盘子 → 该松手了"。考试时虽然看不到标准答案,但只要画面来了,它就知道该做什么。这正是"模仿学习(Imitation Learning)"的意义——从示范中学会本领,然后独立上岗。